В корпусе FORESIGHT языковые модели размечают видео с YouTube-каналов беларусских госСМИ: эмоциональный тон, главную технику пропаганды, мишени. В одной из версий кодировки три поля этой разметки превратились в свободный текст. Для 15 168 видео модель-разметчик написала больше 8,6 тысячи разных формулировок тона и 10 347 разных техник для 11 915 видео. Построить статистику по такому полю невозможно: большинство формулировок в нём встречаются по одному разу.
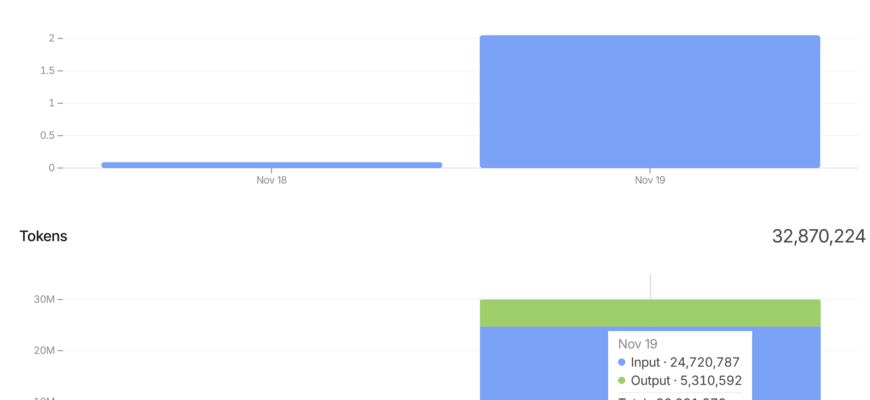
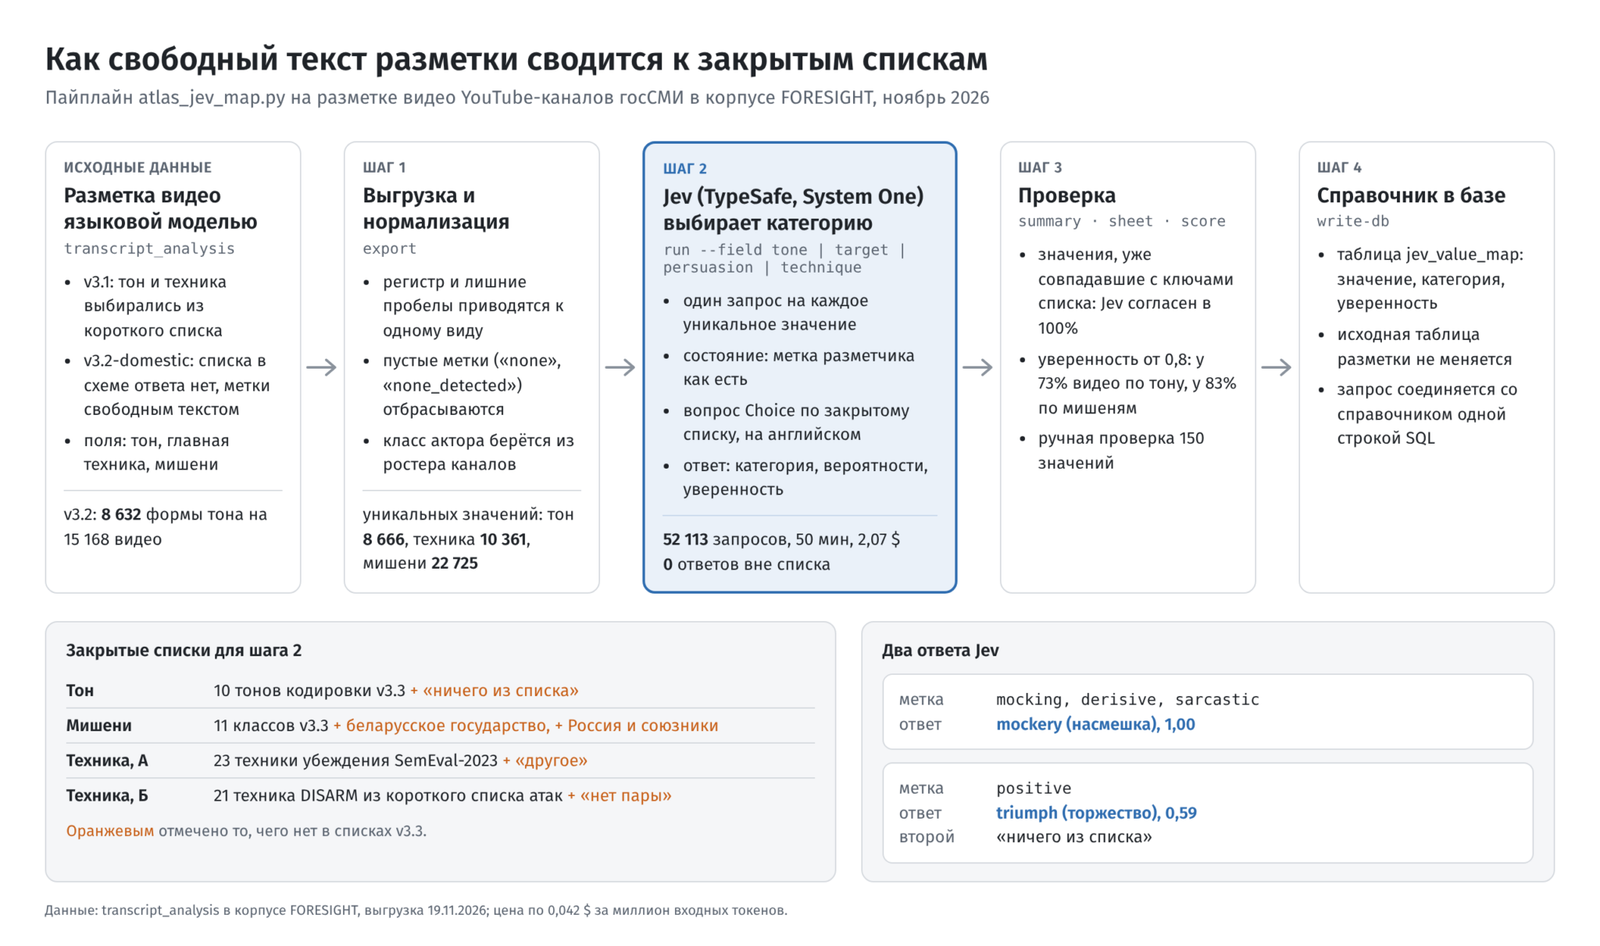
Я свёл эти значения к закрытым спискам с помощью Jev, модели компании TypeSafe. Текста Jev не пишет. Он получает вопрос со списком вариантов и возвращает вероятность для каждого. На это ушло 50 минут и около двух долларов. Из 52 тысяч ответов ни один не вышел за пределы списка.
Как разметка расползлась
В этой истории три версии разметки: старая v3.1 с узким закрытым списком, проблемная v3.2 со свободным текстом и актуальная v3.3, где списки вернули и расширили, — к ним я и приводил старые данные.
В строках без отметки версии (это и есть v3.1) тон и техника выбирались из короткого списка: восемь тонов, от positive до negative, покрывают 99,3% из 6 146 видео. В версии v3.2-domestic, которой закодированы видео января–июня 2026 года, списка в схеме ответа не было, и разметчик стал описывать каждое видео своими словами. Типичная метка тона в ней выглядит так: «confident, reassuring, mildly alarmist regarding external threats, celebratory regarding state achievements». Из 8 632 форм тона v3.2 ровно один раз встречаются 84%.
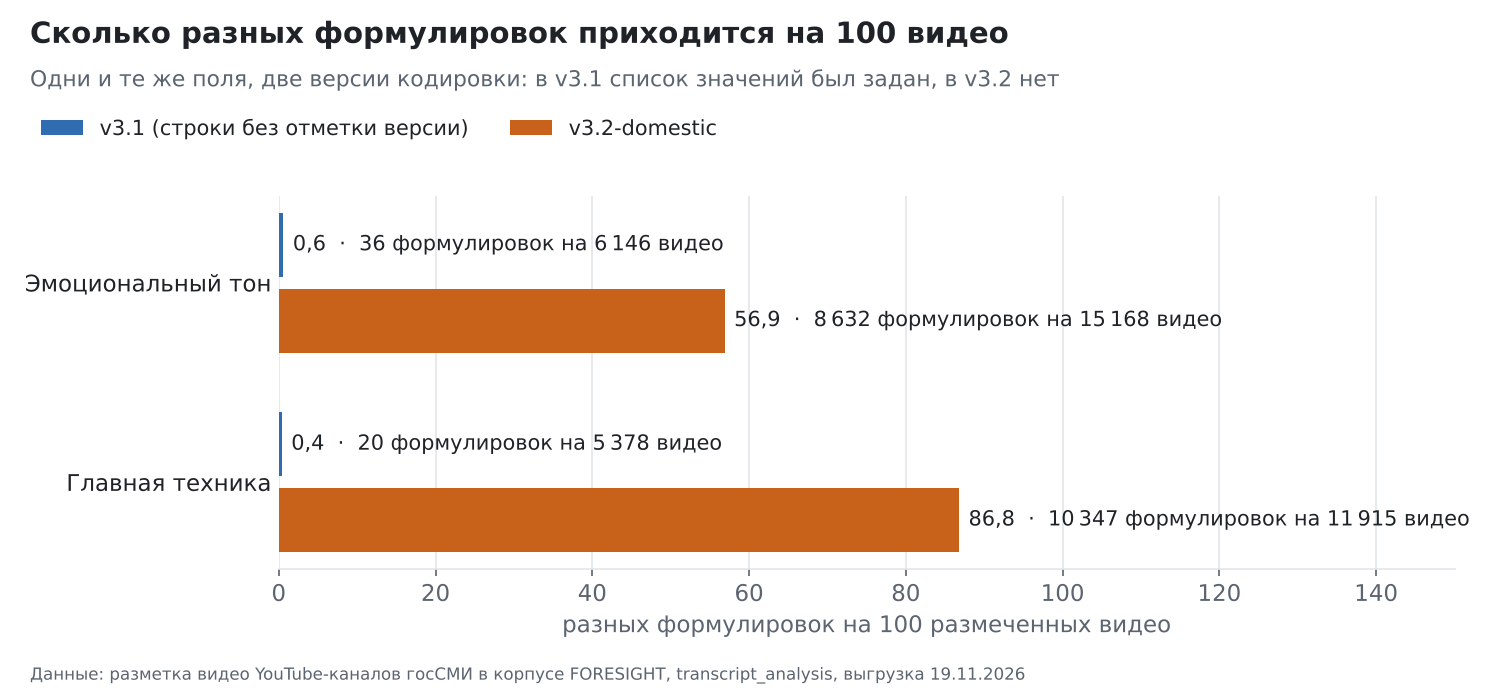
Перестановки слов объясняют малую часть разнобоя. Если считать «mocking, derisive, sarcastic» и «mocking, sarcastic, derisive» одной формой, из 8 666 форм тона остаётся 7 196, то есть уходит примерно шестая часть. Остальное разные слова. Чтобы описать половину видео v3.2, нужны 1 201 самая частая формулировка тона и 4 390 формулировок техники. В v3.1 для этого хватало трёх и одной.

Что делает Jev
Jev относится к моделям, которые TypeSafe называет System One. На вход он получает состояние (здесь это одна метка разметчика) и набор типизированных вопросов: выбор из списка, оценку по шкале, ответ «да или нет». На выходе вероятности и уверенность для каждого варианта. Категорию вне списка эта модель вернуть не может по своей архитектуре, и для моей задачи это главное её свойство: вся беда v3.2 в ответах вне всякого списка.
Списки я взял из текущей версии кодировки v3.3, где перечисления уже стоят в схеме ответа, и кое-что к ним добавил. У тона появился вариант «ничего из списка», чтобы увидеть, чего списку не хватает. У мишеней появились два класса, беларусское государство и Россия с союзниками: в v3.3 их нет, потому что там кодируются только атакуемые. Технику я сводил к двум схемам. Первая схема: 21 техника DISARM (во всём фреймворке их 391 вместе с подтехниками), по которым размечается атакующий слой в Telegram и TikTok. Вторая: 23 техники убеждения из соревнования SemEval-2023. Вопросы задавались по-английски: в прошлом тесте Jev на комментариях YouTube русские формулировки вопросов сдвигали все оценки вверх. Сами метки шли как есть.
| Поле | Разных форм | Категорий после | Запросов | Время | Цена | Видео с уверенностью от 0,8 |
|---|---|---|---|---|---|---|
| Тон | 8 666 | 11 | 8 666 | 8 мин | 0,24 $ | 72,8% |
| Мишени | 23 286 | 13 | 22 725 | 22 мин | 0,85 $ | 82,6% |
| Техника, SemEval-2023 | 10 362 | 22 из 24 | 10 361 | 10 мин | 0,46 $ | 57,2% |
| Техника, DISARM | 10 362 | 21 из 22 | 10 361 | 10 мин | 0,52 $ | 65,8% |
| Всего | — | — | 52 113 | 50 мин | 2,07 $ | — |
Запрос отправлялся на каждую уникальную форму после приведения к нижнему регистру и удаления лишних пробелов, поэтому для мишеней и техник запросов чуть меньше, чем разных форм. Цена посчитана по 0,042 доллара за миллион входных токенов [сверить с кабинетом TypeSafe]. Ошибок API и ответов вне списка ноль.
Чего не было в списке v3.1
После сведения тон двух версий стало можно сравнить. Чтобы период совпадал, я взял только видео января–июня 2026 года: 2 312 в v3.1 и 15 168 в v3.2. Это разные видео одного полугодия.

В v3.2 первое место у насмешки, 26,5% видео. В v3.1 насмешки нет совсем, потому что в её списке такого слова не было. Такие видео разметчик v3.1, по всей видимости, относил к презрению (12,8% против 4,2% в v3.2) или к страху. Список v3.1 не давал назвать тон, который в разметке v3.2 оказался самым частым, а v3.2 назвала его 1 080 разными формулировками. Jev вернул этот словарь в список, где насмешка уже предусмотрена.
Из этого сравнения можно узнать о словаре двух разметчиков. О том, как менялось госТВ, по нему судить нельзя: у версий разные промпты и разные видео.
В «ничего из списка» ушло 11,1% видео. Самые частые такие метки тёплые и ностальгические («warm, nostalgic, celebratory»), лёгкий юмор («light-hearted, humorous») и траур («solemn, mournful, patriotic, reverent»). Для памятных сюжетов и доброй шутки в списке v3.3 места нет. Сюда же с уверенностью 0,64 попала метка «negative» (266 видео): это оценка со знаком минус, эмоцию она не называет. Самое крупное спорное решение Jev принял по «positive». Эта метка стоит у 1 568 видео, четверти всей v3.1, и Jev отнёс её к торжеству с уверенностью 0,59.
Кого разметчик считал мишенью
Поле target_entities в схеме называется «мишени». После сведения к классам видно, что в двух версиях оно значит разное. В v3.1 у 80,2% видео среди «мишеней» есть беларусское государство или Россия с союзниками; Alexander Lukashenko и ОДКБ стоят в первой дюжине самых частых значений. Там поле фиксировало всех упомянутых. Для v3.2 промпт переписали так, чтобы он требовал названных атакуемых внутри страны. Доля государства и союзников упала до 5%, а ярлыки вроде «беглых» и «змагаров» выросли с 12,7% до 54,7% видео.

Без классов эту разницу пришлось бы искать в 23 тысячах форм на двух алфавитах. В «ничего из списка» у мишеней ушло всего 1,4% видео. Среди таких значений YouTube, «Пари Сен-Жермен», «Бенфика» и «Ювентус»: спортивные новости тоже получили своих «мишеней».
Риторика и операции
Метки техники в v3.1 написаны словарём, который Институт анализа пропаганды составил в 1937 году: name calling, glittering generalities, transfer, plain folks, card stacking, bandwagon. Самая частая метка, appeal_to_authority, стоит у 61% видео v3.1. Скорее всего, так разметчик отмечал любую цитату официального лица, и для анализа техник это поле v3.1 почти ничего не даёт.
Две схемы дали очень разный результат. В списке SemEval-2023 пару нашли 88,7% меток v3.1 и 70,8% меток v3.2. В списке DISARM не нашлось ни одной пары для меток v3.1, а среди меток v3.2 совпали только 27,6%. DISARM описывает поведение операций влияния, например координацию сетей или преследование людей. Разметчик описывал риторику одного видео, и прямой пары в атакующем списке у неё обычно нет. Там, где пара нашлась, в v3.2 чаще всего стоят дискредитация оппонента (Smear, 8,4% видео), язык ненависти (Spread Hate, 6,5%), травля (Harass, 4,4%) и конспирологические нарративы (3,6%).

Ошибки у Jev тоже видны. Метку black_and_white (21 видео) он отправил в «ничего из списка» с уверенностью 0,75, хотя это и есть ложная дилемма из SemEval; в его ответе она стояла вторым вариантом. Подчёркивание тут ни при чём: теги appeal_to_authority и name_calling Jev сводил верно с уверенностью 1,00. Скорее всего, он не связал старое название приёма с вариантом false_dilemma, в описании которого слов black and white нет.
Что проверено и чего Jev не видит
Jev видит только метку разметчика, самого видео он не видит. Если разметчик ошибся, Jev эту ошибку унаследует. Когда в метке перечислено несколько тонов, он выбирает главный или первый, и остальные теряются.
Простая проверка встроена в сами данные. Значения, которые уже совпадали с ключами списка, Jev везде отнёс к ним же: для техник SemEval это 9 значений у 4 515 видео, для тона одно значение у 1 182 видео. Уверенность не ниже 0,8 у 72,8% видео по тону и у 82,6% по мишеням. Вручную сведение никто не проверял.
Вместо этого 150 значений, по 50 из тона, мишеней и техник SemEval, половину с весом по числу видео, проверила вторая модель, Claude Opus 5.5, по тем же спискам. Независимой такую проверку назвать нельзя: модели того же семейства делали исходную разметку и помогали составлять описания категорий. По девяти значениям Claude суждения выносить не стал: там неизвестные фамилии, непонятно, о каком парламенте речь, и спорная «positive». Из остальных 141 он согласился с Jev в 128 случаях (91%). Все 86 значений с уверенностью Jev от 0,8 он признал верными, ошибки собрались ниже этого порога, где совпали 42 из 55. Типичная ошибка выглядит так: Jev отправляет в «ничего из списка» метку, для которой в списке есть место, например «festive, warm, nostalgic», где первое слово указывает на торжество. Бывают и ошибки по фактам: замглавы МИД Галузин, российский дипломат, попал к беларусскому государству, а Молодёжный парламент при Национальном собрании оказался среди оппозиционных структур.
Что я вынес из работы с Jev
- Jev создан для закрытых списков с коротким контекстом. Он хорош там, где ответ сводится к выбору из готовых вариантов, а весь нужный контекст помещается в одну строку. Нормализация меток как раз такая задача, и за 50 минут она прошла без единого сбоя.
- Качество определяет список, а не формулировка вопроса. Где список неполон, Jev новой категории не придумывает, и такой пробел сразу виден по низкой уверенности и ответам «ничего из списка». Так нашлись памятные сюжеты, которым в v3.3 нет места, и общие ярлыки вроде «positive», называющие только знак.
- Итерации со списками почти ничего не стоят. Основная работа сдвигается в проектирование списков, и проверять гипотезы стало дёшево: поменять список тонов и прогнать всё заново стоит 24 цента и восемь минут, а сравнение SemEval с DISARM обошлось меньше чем в доллар.
- Уверенность модели работает как готовый фильтр. Значения с уверенностью от 0,8 можно принимать автоматически, а остальное отдавать человеку или большой языковой модели; по тону это 27% видео.
- Модель не видит корпус целиком. Слабое место у Jev то же, что и в тесте на комментариях YouTube: о контексте вокруг строки он ничего не знает. Повторы и закономерности по всему массиву считают SQL-запросы по справочнику, а Jev даёт им чистые категории.
Справочник вместо переразметки
Результат лежит в базе отдельной таблицей jev_value_map: около 52 тысяч исходных значений с их категориями и уверенностью, у мишеней рядом сведение к классам v3.3. Исходная таблица разметки не тронута. В v3.3 перечисления уже стоят в схеме ответа, так что разметке по ней такая чистка не понадобится. Для архива любой запрос по тону или мишеням теперь соединяется со справочником одной строкой SQL.